AI 뉴스 에이전트 개발기: 하룻밤 구현, 한 달 필터 수정
예전에 운영하던 게임 업계 바이브 코딩 모임에 AI 뉴스 에이전트를 붙인 적이 있다. 이하 뉴스봇이라고 부르겠다. 코드는 Claude가 하룻밤에 다 짰다. 오래 걸린 건 그다음이었다. 봇이 무엇을 거르고 무엇을 내보낼지 기준을 맞추는 데 한 달 가까이 걸렸다. 지금은 봇을 쓰지 않는다. 그때 커밋 기록에 남은 숫자를 보면서 정리해둔다.
왜 만들었나
관심 있는 사람은 소식을 알아서 찾아본다. 막 입문한 사람은 다르다. 정보가 어디 있는지 찾는 것부터가 벽이다. 모임 채널에 최신 소식이 알아서 올라오면 그 벽 하나는 치워줄 수 있겠다고 생각했다.
구조는 단순하다. RSS, Hacker News, Reddit, X에서 글을 모은다. LLM이 게임 개발자에게 쓸모 있는지 점수를 매긴다. 통과한 글만 요약을 붙여 디스코드 채널에 올린다. 맥 한 대에서 launchd로 정해진 시간마다 돌렸다.
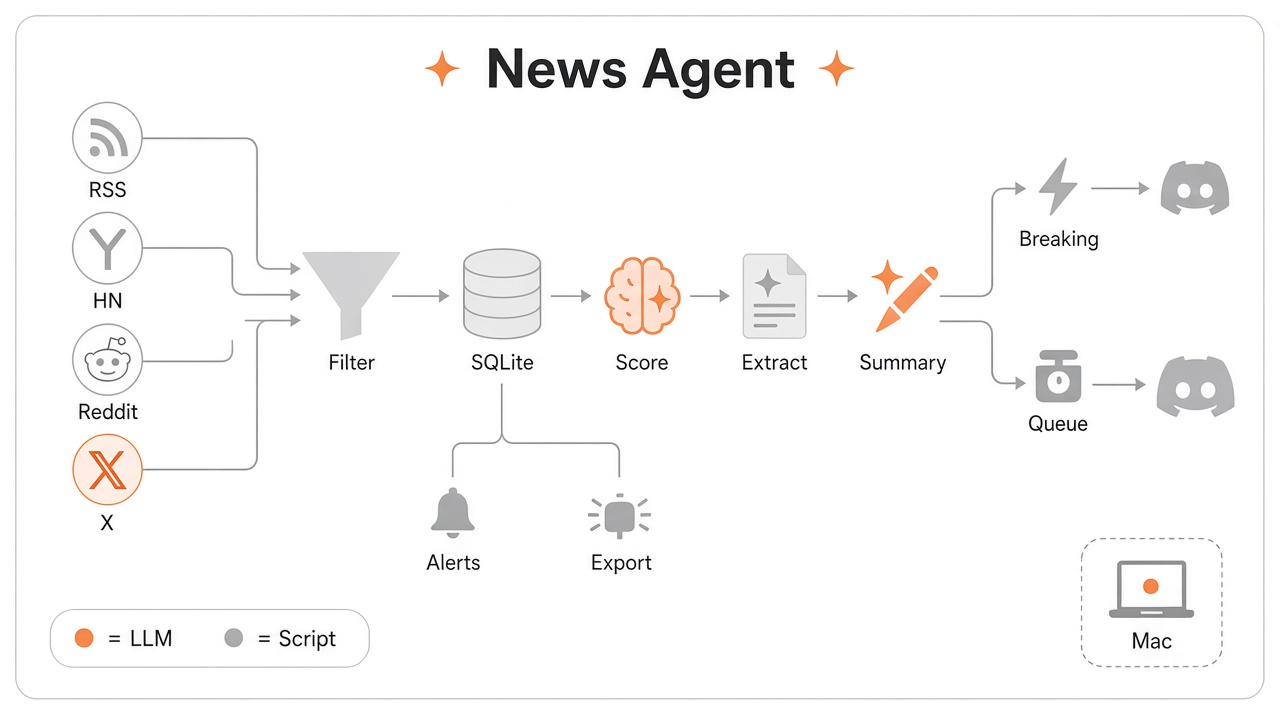
구현은 하룻밤이었다
먼저 스펙, 파이프라인 설계, 구현 계획을 문서로 썼다. 다음 날 저녁 Claude가 그 계획대로 수집기, 저장소, 점수 매기기, 요약, 발송을 20분이 안 돼서 커밋했다. 바로 이어서 버그도 몇 개 고쳤다. 같은 글이 두 번 발송되는 문제, 디스코드 글자 수 제한, 동시 실행 시 SQLite 잠금 같은 것들이다.
코드는 전부 Claude에게 맡겼다. 내가 한 일은 실제로 무엇이 수집되고 무엇이 올라갔는지 보는 것, 그리고 이상하면 프롬프트나 수집 방식을 고치라고 시키는 것이었다. 이 글에 나오는 시행착오도 대부분 그렇게 시작했다. 뭔가 이상하다 싶으면 점검을 시켰고, 원인과 숫자는 Claude가 커밋에 남겼다.
첫 주: 줄이는 쪽으로
처음 버전은 요약을 기획자, 프로그래머, 아티스트 관점으로 세 번 나눠 썼다. 길기만 하고 읽을 이유는 늘지 않았다. 다음 날 바로 한 줄 요약으로 바꿨고, 디스코드 임베드 대신 링크가 걸린 일반 텍스트로 보냈다.
통과 기준도 올렸다. 처음엔 5점 만점에 3점이면 통과였다. 그런데 "알아두면 좋은" 3점짜리가 하루 발송 한도 7건보다 빨리 쌓였다. 최근 사흘 동안 통과한 12건 중 10건이 3점이었다. 그래서 4점 이상만 내보내게 했다. 대기열에서 사흘이 지난 글은 버리게 했다.
보안 구멍도 하나 있었다. 피드 제목과 요약을 그대로 메시지에 넣다 보니, 제목에 @everyone이 들어 있으면 채널 전체에 알림이 갈 수 있었다. 메시지를 보낼 때 멘션을 전부 꺼서 막았다. 외부 글을 채널에 그대로 옮기는 봇이라면 처음부터 꺼두는 게 맞다.
필터가 읽을 만한 글을 버리고 있었다
진짜 문제는 2주쯤 지나서 나왔다. 봇은 멀쩡히 도는데 정작 읽을 만한 글이 안 올라왔다.
첫 번째는 키워드 사전 필터였다. 국내 게임 매체 기사는 양이 많아서, LLM에 넘기기 전에 키워드로 한 번 걸렀다. 이 키워드 목록은 예전 로그로만 검증했고, 실제로 돌린 뒤 무엇이 살아남는지는 보지 않았다. 운영해보니 한 매체에서 기간 안의 기사 22건 중 18건이 버려졌다. 살아남은 4건 중 3건은 "스팀"에 걸린 게임 할인 글이었다. "스팀"은 13일 동안 제목 31개를 끌어왔는데 3점 이상은 하나도 없었다. 결국 실제 제목 490개를 놓고 키워드마다 쓸모 있는 글이 몇 건 걸리는지 재서 다시 골랐다. 그 숫자는 설정 파일에 같이 적어뒀다. 다음에 고칠 때 근거부터 보라는 뜻이다.
두 번째는 점수 기준 문구 한 줄이었다. 2점 기준에 "4점은 외부 컨퍼런스 기술 세션으로 한정한다"는 문장이 있었다. 원래는 홍보성 기사가 4점을 받지 못하게 하려던 문장이었다. 그런데 대상을 적지 않아서 모든 글에 걸리는 제한이 됐고, 실무자가 쓴 글도 4점을 받을 수 없었다. 사흘 연속으로 4점이 0건이었고 아무것도 발행되지 않았다. 그래서 이 제한은 홍보성 글에만 걸고, 실무 글은 적용 단계, 방법, 결과 셋 중 둘이 있으면 4점까지 갈 수 있게 바꿨다. 같이 살펴보다가 검증 안 된 개인 프로젝트가 아무 표시 없이 나가고 있었다는 것도 알았다. 이미 6건이 그렇게 나갔고, 그중 3건은 미완성 작업에 피드백을 구하는 글이었다. 그래서 이런 글에는 검증 안 된 프로젝트라는 표시를 달았다.
세 번째는 오픈웨이트 모델이었다. DB에 있던 오픈웨이트 관련 글 16건 중 15건이 잘렸다. 최고 점수가 3점이었고, 이유는 "게임 개발 파이프라인 직접 영향 제한적" 같은 식이었다. 이 모임에는 맞지 않는 판단이다. 로컬에서 돌릴 수 있는 모델은 혼자 만드는 개발자에게 API로만 쓰는 모델 하나보다 더 중요할 수 있다. 점수 기준에 오픈웨이트를 넣고, X 수집 계정에 오픈웨이트 모델을 내는 연구소들을 추가했다.
수집 단계에서 아예 못 들어오는 것도 있었다. 7월 28일에 나온 MCP 스펙이 파이프라인에 한 번도 들어오지 않았다. 고장 난 데는 없었다. 들어올 길이 없었을 뿐이다. Hacker News 수집 설정에 에이전트나 MCP 같은 도구 표준 관련 키워드가 없었고, 국내 매체는 제목에 "MCP"를 쓰지 않았다. Qwen도 비슷했다. 48시간 표본에서 3건, 그것도 URL에만 걸린다고 키워드를 뺐는데, 30일로 늘려 보니 새로 걸리는 제목이 11건이었다.
세 경우 모두 봇은 에러 없이 잘 돌았다. 그래서 더 늦게 알았다. 결과를 직접 보지 않았으면 계속 몰랐을 거다.
Grok에서 Claude로
처음엔 점수 매기기와 요약을 xAI API의 Grok으로 돌렸다. Grok 성능이 기대만큼 안 나와서 중간에 Claude CLI로 옮겼다. X 글 수집은 x_search를 써야 해서, 마지막 설정에서도 Grok으로 돌아간다.
X 쪽에도 작은 함정이 있었다. 수집 계정 목록이 20개를 넘으면 뒤쪽이 아무 경고 없이 잘린다. 계정을 늘릴 때 개수를 확인하지 않으면 새로 넣은 계정이 조용히 빠진다.
회고
설계할 때 처음부터 정한 게 하나 있다. 확률적으로 움직이는 부분과 결정적으로 움직이는 부분을 나누는 거다. LLM은 판단이 필요한 곳에만 쓰고, 정해진 규칙으로 처리할 수 있는 일은 전부 스크립트에 넘겼다. LLM 호출을 줄이려는 이유가 컸다. 그래서 스크립트가 맡은 일이 생각보다 많다.
- 스크립트: RSS, Hacker News, Reddit 수집. 매체별 제목 키워드 사전 필터. URL 정규화와 해시로 같은 링크 거르기. 본문 추출. 대기열, 하루 발송 한도, 3일 지난 글 만료. 디스코드 발송과 멘션 차단. 정해진 시간 실행과 실행 잠금.
- LLM: 점수 매기기와 같은 사건 판단, 한 줄 요약. X는 예외였다. 수집 자체를 x_search가 해야 해서 수집 단계에도 LLM이 들어갔다.
이렇게 나누면 고칠 곳이 분명해진다. 키워드 필터가 기사를 너무 많이 버리면 숫자를 재서 목록을 고치면 된다. 점수가 이상하면 프롬프트를 보면 된다. 반대로 X 수집처럼 LLM에 판단을 조금이라도 맡긴 곳에서는 문제가 생겼다. 수집 프롬프트가 "게임 개발자에게 의미 있는 소식"만 가져오라고 해서, 이틀 동안 X에서 아무것도 안 들어왔다. 수집은 다 가져오게 하고 판단은 점수 단계 하나에 모으고 나서야 풀렸다.
소스를 많이 붙인 덕에 빠지는 소식은 적었다. 대신 중복 거르기가 어려워졌다. 같은 발표가 공식 블로그, 언론 기사, HN, X로 따로 들어온다. 이건 스크립트로는 못 거르고 LLM에 보내는 프롬프트를 계속 고쳐야 했다.
- 처음: URL을 정규화해서 해시로 비교하는 것뿐이었다. 링크가 다르면 다른 글로 봤다.
- 7월 23일: 유니티 키노트가 27시간 동안 4번 올라갔다. 그중 3번은 같은 피드가 시간차를 두고 다시 보도한 글이었다. 그래서 최근 제목 목록을 같이 넘기고, 같은 사건이면 매체나 형식과 상관없이 1점을 주게 했다. 이 규칙은 다른 점수 기준보다 우선한다.
- 7월 25일: 공식 출시 글이 "출시 미확인"으로 2점을 받고 잘렸다. 프롬프트에 URL이 안 들어가서, 공식 출처인지 알 방법이 없었다. URL을 넘기고, 같은 사건이면 공식 출처를 남기게 했다.
- 7월 26일: 이번엔 둘 다 공식 출처였다. 같은 모델 발표가 블로그 글과 콘솔 페이지로 1초 차이로 두 번 나갔고, 이틀 뒤 X로 한 번 더 나갔다. 기존 규칙은 "공식 출처가 없을 때만" 중복을 걸렀다. 이제는 항상 하나만 남기고, 남길 순서를 정했다.
- 8월 12일: 중복 발행 5건을 추적하니 구멍이 세 개였다. 다시 보도한 글이 3일, 7일, 14일 뒤에 들어왔는데 참조 범위는 48시간이었다. 한국어 기사와 영어 기사는 제목만으로 같은 사건인 걸 못 알아봤다. 공식 출처가 나중에 들어오면 이미 대기 중인 글을 뺄 방법이 없었다. 참조 범위를 14일로 늘리고, 날짜와 출처를 같이 넘기고, 더 나은 출처가 오면 대기 중인 글을 밀어내게 했다.
돌아보면 중복은 한 번에 풀리는 문제가 아니었다. 구멍 하나를 막으면 다음 구멍이 실제 발행에서 드러났다. 매번 실제 사례를 테스트 데이터로 박아두고 나서야 같은 실수가 반복되지 않았다.
투표봇도 하나 붙였다
모임용으로 선착순 신청 봇도 만들었다. 옵션마다 정원이 있고, 자리가 나면 대기자가 자동으로 올라가고 DM이 간다. 리뷰에서 걸린 문제가 하나 있었다. 신청에서 빠진 사람들에게 DM을 보냈다고 답하는데, 실제로는 DM을 보내기도 전에 그렇게 답하고 있었다. DM이 막힌 사람은 자리를 잃었다는 걸 모르고, 다른 사람도 그걸 알 수 없다. DM을 먼저 보내고, 못 받은 사람 이름을 답에 적게 고쳤다.
그래서 어땠나
참여가 높지는 않았다. 가끔 피드백이 왔고, 도움이 됐다는 사람도 있었다. 지금은 봇을 쓰지 않는다.
에이전트에게 코드를 맡기면 구현은 금방 끝난다. 시간이 드는 건 결과물을 직접 보고 기준을 고치는 일이고, 그 일은 봇을 돌리는 동안 계속된다. 필터가 에러 없이 조용히 틀리면 로그만 봐서는 모른다. 실제로 무엇이 올라갔고 무엇이 버려졌는지 봐야 한다.